Recovery Behaviors: robot phải làm gì khi bị kẹt
Atlasbot · 17/8/2026 · 11 phút đọc
Bài Behavior Tree đã cho thấy Fallback chuyển sang nhánh recovery khi luồng chính thất bại. Bài này đi vào chi tiết các recovery behavior cụ thể — hành vi robot thực hiện để tự thoát khỏi tình huống bế tắc, trước khi thực sự báo lỗi lên tầng ứng dụng.
Khái niệm chính
Bốn recovery behavior phổ biến, mỗi loại giải quyết một tình huống bế tắc khác nhau:
Spin      — xoay tại chỗ một góc — "nhìn" rõ hơn môi trường xung quanh,
            đôi khi đủ để costmap cập nhật lại và thấy đường đi mới
BackUp    — lùi một đoạn ngắn — thoát khỏi tình huống quá gần vật cản
            phía trước, tạo thêm không gian cho planner tính lại
Wait      — đứng yên một khoảng thời gian — hữu ích khi vật cản là
            người/vật đang di chuyển, chỉ cần đợi họ đi qua
ClearEntireCostmap — xoá sạch costmap cục bộ, buộc dựng lại từ dữ liệu
            cảm biến mới nhất — hữu ích khi costmap "kẹt" dữ liệu cũ sai
Nguyên lý hoạt động
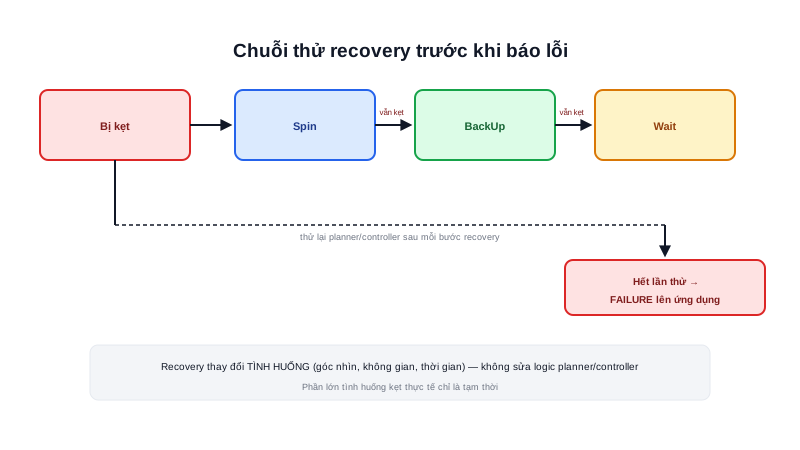
Không có recovery: 1 lần thất bại → robot dừng, chờ người can thiệp
Có recovery: thất bại → thử Spin → vẫn thất bại → thử BackUp
             → vẫn thất bại → thử Wait → ... → mới thực sự báo lỗi
Phần lớn tình huống "kẹt" trong thực tế là tạm thời (người đi ngang qua, costmap có dữ liệu nhiễu tạm thời) — recovery behavior cho robot cơ hội tự thoát ra mà không cần con người can thiệp mỗi lần, đúng tinh thần tự động hoá mà cả hệ Navigation hướng tới.
Tóm lại: Recovery không phải "sửa lỗi thuật toán" — planner/controller vẫn đúng logic của chúng, chỉ là tình huống hiện tại (costmap có dữ liệu tạm thời sai, hoặc robot ở vị trí khó) khiến chúng thất bại. Recovery thay đổi tình huống (xoay để thấy góc khác, lùi để có thêm không gian, đợi để vật cản động di chuyển đi) rồi để planner/controller thử lại với tình huống mới, không phải thay thế logic của chúng.
Kiến thức kỹ thuật
Công thức
bt_navigator:
  ros__parameters:
    default_nav_to_pose_bt_xml: navigate_to_pose_w_replanning_and_recovery.xml

recoveries_server:
  ros__parameters:
    recovery_plugins: ["spin", "backup", "wait"]
    spin:
      plugin: "nav2_behaviors::Spin"
Số lần lặp lại chuỗi recovery trước khi thực sự trả về FAILURE lên tầng ứng dụng thường được cấu hình ngay trong file Behavior Tree XML (qua RecoveryNode với tham số number_of_retries) — không giới hạn cứng trong code, dễ điều chỉnh theo đặc thù môi trường vận hành:
Tổng_thời_gian_thử_recovery_tối_đa = number_of_retries × (Thời_gian_mỗi_lần_thử + Thời_gian_thử_lại_luồng_chính)

VD: number_of_retries = 3, mỗi Spin mất ~3s, thử lại ComputePathToPose+FollowPath mất ~2s
Tổng_thời_gian_tối_đa ≈ 3 × (3+2) = 15 giây trước khi báo FAILURE lên tầng ứng dụng
Thông số
| Recovery behavior | Giải quyết tình huống | Chi phí thời gian |
|---|---|---|
| Spin | Costmap thiếu dữ liệu góc nhìn hiện tại | Thấp (vài giây) |
| BackUp | Quá gần vật cản phía trước | Thấp (vài giây) |
| Wait | Vật cản động tạm thời (người đi qua) | Trung bình (tuỳ thời gian chờ cấu hình) |
| ClearEntireCostmap | Costmap kẹt dữ liệu cũ sai | Rất thấp (tức thời) |
Ứng dụng thực tế
Môi trường đông người có thể cần nhiều lần thử Wait hơn môi trường tĩnh — đây là ví dụ cụ thể cho việc tinh chỉnh number_of_retries và thứ tự recovery behavior theo đặc thù môi trường vận hành thực tế, không dùng chung một cấu hình mặc định cho mọi loại kho hàng. Sau khi hết số lần thử recovery cấu hình, Behavior Tree trả về FAILURE cuối cùng lên node đã gọi nó (thường là action server NavigateToPose) — tầng ứng dụng (logic nghiệp vụ cụ thể, đã nhắc ở bài Bức tranh toàn cảnh phần mềm robot) nhận được thông báo thất bại này và quyết định bước tiếp theo — có thể là báo cho người vận hành, thử lại sau một khoảng thời gian, hoặc chuyển sang nhiệm vụ khác, đúng vai trò máy trạng thái đã học ở bài Application Layer trong AMR.
Ví dụ thực tế
<RecoveryNode number_of_retries="3" name="NavigateRecovery">
  <PipelineSequence>
    <ComputePathToPose goal="{goal}" path="{path}"/>
    <FollowPath path="{path}"/>
  </PipelineSequence>
  <ReactiveFallback>
    <Spin spin_dist="1.57"/>
    <Wait wait_duration="5"/>
    <BackUp backup_dist="0.3"/>
  </ReactiveFallback>
</RecoveryNode>
Kịch bản: robot AMR trong kho đông người, gặp người đứng chắn đường hẹp

Lần thử 1: FollowPath FAILURE (người chắn đường) -> Spin (nhìn góc khác, không giúp ích)
Lần thử 2: vẫn FAILURE -> Wait 5 giây (người có thể đã di chuyển đi)
Lần thử 3: FollowPath SUCCESS (người đã đi qua trong lúc Wait)

Nếu cả 3 lần đều thất bại: RecoveryNode trả FAILURE lên bt_navigator,
action NavigateToPose báo lỗi lên Application Layer, hệ thống có thể
thông báo cho người vận hành hoặc thử lại sau
Lỗi thường gặp
- Đặt
number_of_retriesquá thấp cho môi trường đông người/vật cản động thường xuyên — robot báo lỗi quá sớm dù tình huống thực tế chỉ cần đợi thêm chút thời gian. - Đặt
number_of_retriesquá cao, thời gian chờ recovery quá dài — như tính ở mục Công thức, robot có thể "kẹt" thử recovery quá lâu trước khi báo lỗi, ảnh hưởng trải nghiệm vận hành thực tế nếu tình huống thực sự cần con người can thiệp sớm. - Chỉ dùng 1 loại recovery behavior cho mọi tình huống — mỗi behavior giải quyết đúng một loại bế tắc cụ thể (bảng Thông số), thiếu đa dạng khiến robot không tự thoát được nhiều tình huống khác nhau.
- Không phân biệt recovery cho vấn đề tạm thời và vấn đề thực sự cần can thiệp — thử recovery vô hạn cho một tình huống không thể tự giải quyết (VD: đường thực sự bị chặn vĩnh viễn) lãng phí thời gian thay vì báo lỗi sớm cho người vận hành.
Kết luận
Recovery behaviors cho robot cơ hội tự thoát khỏi tình huống bế tắc tạm thời trước khi cần con người can thiệp — mỗi behavior (Spin, BackUp, Wait, ClearEntireCostmap) giải quyết đúng một loại tình huống cụ thể, không phải "sửa lỗi thuật toán" mà là thay đổi tình huống để planner/controller thử lại. Cấu hình đúng number_of_retries và thứ tự recovery theo đặc thù môi trường vận hành là bước tinh chỉnh quan trọng. Bài cuối cùng của chuyên mục Nav2, Waypoint Follower, đi vào bài toán đi qua nhiều điểm liên tiếp — mở rộng từ điều hướng tới 1 điểm đã học xuyên suốt chuyên mục này.