Multi-threading trong ROS2 — khi nào cần, khi nào không
Atlasbot · 17/8/2026 · 11 phút đọc
Người mới thường nghĩ multi-threading trong ROS2 là để tăng tốc độ xử lý, giống lập trình đa luồng thông thường. Thực ra vấn đề nó giải quyết hẹp và cụ thể hơn nhiều: một node có nhiều callback (subscriber, service, timer), mặc định chạy tuần tự trên một luồng duy nhất — nếu một callback bị chậm, toàn bộ callback còn lại của node đó phải xếp hàng chờ, kể cả những callback cần phản hồi tức thì như đọc cảm biến an toàn.
Khái niệm chính
rclpy.spin(node) # thực chất dùng SingleThreadedExecutor bên trong
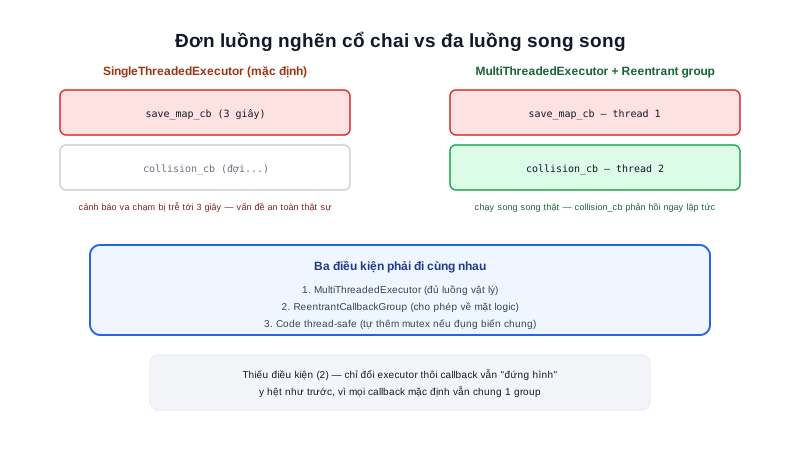
Mọi callback của node — dù đăng ký ở subscriber, timer, hay service khác nhau — đều được xếp vào một hàng đợi, xử lý tuần tự từng cái một trên đúng một luồng. Callback service save_map mất 3 giây để ghi file sẽ khiến callback đọc cảm biến va chạm (cần phản hồi tức thì để dừng khẩn cấp) phải đợi đủ 3 giây đó mới được xử lý — một vấn đề an toàn thực sự, không chỉ là hiệu năng.
Nguyên lý hoạt động
from rclpy.executors import MultiThreadedExecutor

executor = MultiThreadedExecutor(num_threads=4)
executor.add_node(node)
executor.spin()
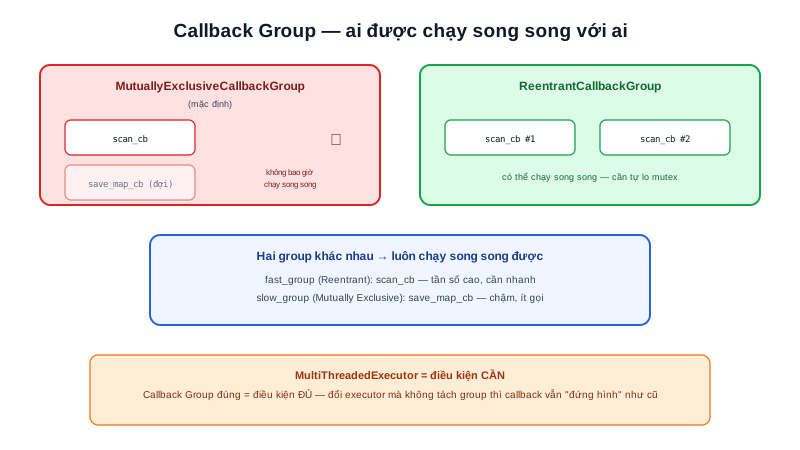
num_threads=4 cấp 4 luồng cho executor phân phối callback. Nhưng chỉ đổi executor thôi chưa đủ — như bài Callback Group đã giải thích, mặc định mọi callback vẫn nằm chung một MutuallyExclusiveCallbackGroup, tự động không cho phép chạy song song dù có bao nhiêu luồng rảnh. Phải cố tình tách callback cần song song sang ReentrantCallbackGroup riêng thì việc thêm luồng mới thực sự có tác dụng.
Tóm lại: Ba khái niệm phải đi cùng nhau mới giải quyết được vấn đề "callback chậm chặn callback nhanh": MultiThreadedExecutor (có đủ luồng vật lý để chạy song song) + Callback Group phù hợp (cho phép về mặt logic) + node code phải thread-safe (nếu nhiều callback cùng đụng vào biến chung, cần mutex tự quản lý — ROS2 không tự lo phần này).
Kiến thức kỹ thuật
Công thức
Số luồng hợp lý cho MultiThreadedExecutor nên tham chiếu theo số nhân CPU thực tế, không phải một con số tuỳ tiện:
num_threads hợp lý ≈ số nhân CPU khả dụng (hoặc số nhân trừ 1, chừa lại cho OS/tiến trình khác)

VD: máy tính robot 4 nhân CPU
num_threads = 4 (dùng hết) hoặc 3 (chừa 1 nhân cho hệ thống)

Vượt quá nhiều so với số nhân thực tế (VD: num_threads=16 trên máy 4 nhân)
không giúp nhanh hơn — các luồng phải tranh giành CPU (context switching),
thêm overhead thay vì thêm hiệu năng thực sự
Thông số
| Thông số | Giá trị |
|---|---|
num_threads mặc định nếu không chỉ định | Tự động lấy theo số nhân CPU phát hiện được |
| Chi phí tạo 1 luồng OS | Nhỏ nhưng không phải 0 — tạo quá nhiều executor/luồng riêng lẻ cho từng node có thể cộng dồn đáng kể trên máy nhúng yếu |
Ứng dụng thực tế
add_node() nhiều lần cho phép nhiều node chia sẻ chung một pool luồng, thay vì mỗi node tự rclpy.spin() riêng (tốn thêm luồng OS cho mỗi lần spin độc lập):
executor = MultiThreadedExecutor()
executor.add_node(motor_node)
executor.add_node(lidar_node)
executor.spin()
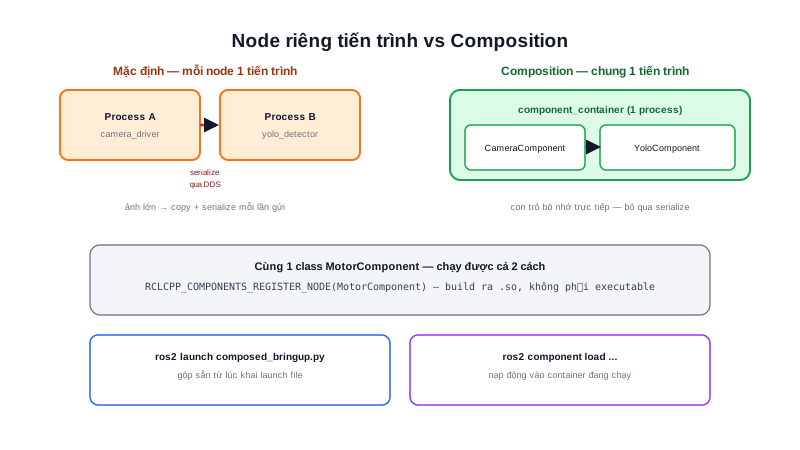
Đây là kỹ thuật hữu ích trên máy tính nhúng tài nguyên hạn chế của AMR — một script bringup gộp nhiều node nhẹ (VD: node tổng hợp chẩn đoán, node quản lý tham số chung) vào chung 1 executor chia sẻ pool luồng, giảm tổng số luồng OS cần quản lý so với việc mỗi node tự chạy rclpy.spin() độc lập trong tiến trình riêng — đây cũng chính là nền tảng kỹ thuật bên dưới của Composition đã học ở bài trước, nơi nhiều component chạy chung tiến trình thường dùng chung một executor kiểu này.
Bảng quyết định nhanh khi nào cần cấu hình gì:
| Tình huống | Giải pháp |
|---|---|
| Node chỉ có 1-2 callback đơn giản, không callback nào chậm | SingleThreadedExecutor (mặc định) là đủ |
| Có callback chậm (I/O, tính toán nặng) cần tách khỏi callback nhanh | MultiThreadedExecutor + ReentrantCallbackGroup cho callback nhanh |
| Nhiều node cần chia sẻ tài nguyên tính toán, giảm overhead luồng | MultiThreadedExecutor + add_node() nhiều lần |
| Callback đụng chung biến/state — nhiều callback cùng ghi | Vẫn cần tự thêm threading.Lock() dù dùng executor nào |
Ví dụ thực tế
Kịch bản minh hoạ vấn đề (SingleThreadedExecutor mặc định):

[10:00:00.000] Callback save_map bắt đầu (ghi file, mất 3 giây)
[10:00:00.500] Sự kiện va chạm xảy ra — callback estop_cb đáng lẽ phải chạy NGAY
[10:00:03.000] Callback save_map kết thúc
[10:00:03.001] Callback estop_cb CUỐI CÙNG mới được chạy — trễ tới 2.5 giây!
Cùng kịch bản, với estop_cb ở ReentrantCallbackGroup riêng + MultiThreadedExecutor:

[10:00:00.000] Callback save_map bắt đầu (luồng 1)
[10:00:00.500] Sự kiện va chạm xảy ra
[10:00:00.501] Callback estop_cb chạy NGAY trên luồng 2, không chờ save_map
Chênh lệch 2.5 giây độ trễ ở kịch bản đầu minh hoạ chính xác lý do vì sao đây là vấn đề an toàn thực sự, không chỉ là "chạy chậm" thông thường.
Lỗi thường gặp
- Chỉ đổi executor mà quên tách Callback Group — như đã nói ở phần Nguyên lý hoạt động, đây là lỗi phổ biến nhất, khiến việc đổi sang
MultiThreadedExecutor"không có tác dụng gì" nhìn từ bên ngoài. - Cấp quá nhiều luồng so với số nhân CPU thực tế — như đã tính ở mục Công thức,
num_threadsvượt xa số nhân vật lý chỉ tăng overhead chuyển đổi ngữ cảnh, không tăng hiệu năng thực sự. - Không tự bảo vệ dữ liệu chia sẻ bằng lock khi dùng ReentrantCallbackGroup — như đã nhắc ở bài Callback Group, ROS2 không tự động thread-safe hoá code của bạn.
- Dùng MultiThreadedExecutor mặc định "cho chắc" dù không cần thiết — thêm độ phức tạp (phải suy nghĩ về callback group, race condition) cho node đơn giản không có callback nào chậm — chỉ nên dùng khi thực sự có nhu cầu tách callback chậm/nhanh.
Kết luận
Multi-threading trong ROS2 giải quyết đúng vấn đề "callback chậm chặn callback nhanh trong cùng node", không phải công cụ tăng tốc chung chung — cần cả 3 yếu tố đi cùng nhau: đủ luồng, callback group đúng loại, và code thread-safe. Bài tiếp theo trong chuyên mục, cũng là bài áp chót, nói về Executor — đào sâu hơn vào cơ chế lập lịch callback mà cả MultiThreadedExecutor lẫn Callback Group đều dựa vào.