Điểm tin AI cho robot tháng 9/2026: Helix 2.5, Skild S1, GEN-1.5 — robot học việc mới chỉ từ vài giây video
Atlasbot · 5/10/2026 · 6 phút đọc
"Physical AI", tức AI điều khiển cơ thể vật lý, là chủ đề nóng nhất của ngành robot năm 2026. Chỉ riêng tháng 9 đã có một loạt mô hình nền tảng (foundation model) cho robot được công bố. Bài này điểm qua 4 mô hình đáng chú ý nhất và quan trọng hơn là cách đọc đúng các con số họ công bố.
1. Figure Helix 2.5: dọn nhà ở 30 căn hộ chưa từng thấy
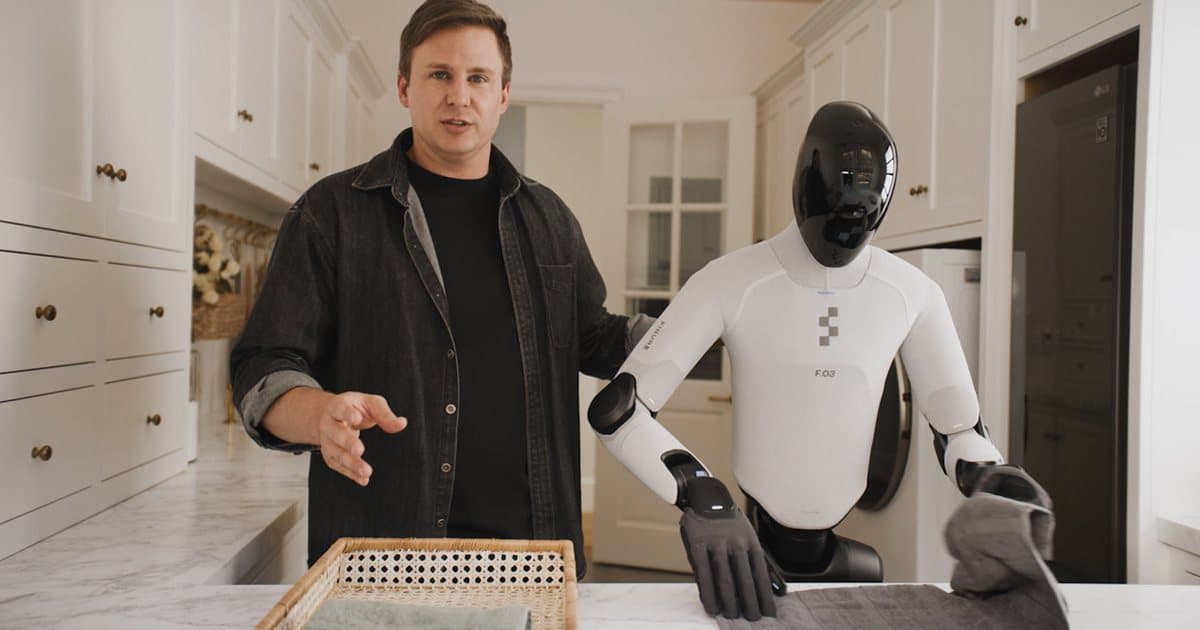
Helix là mô hình vision-language-action (VLA) của Figure: nhận hình ảnh và câu lệnh ngôn ngữ, xuất ra hành động cho robot. Phiên bản 2.5 được thử nghiệm với các việc nhà như dọn đồ chơi, gấp khăn, dọn giường trong 30 ngôi nhà lạ, không fine-tune thêm cho từng nhà.
Điểm mấu chốt nằm ở dữ liệu. Figure tiền huấn luyện mô hình trên Index, bộ dữ liệu hành vi con người của hãng. Nhờ đó, tỉ lệ hoàn thành trọn vẹn nhiệm vụ (gộp các loại việc) tăng từ 8% lên 56%, tức từ 35/420 lên 237/420 lần thử. Đây là thước đo khắt khe: phải làm xong cả việc, không tính hoàn thành từng phần.
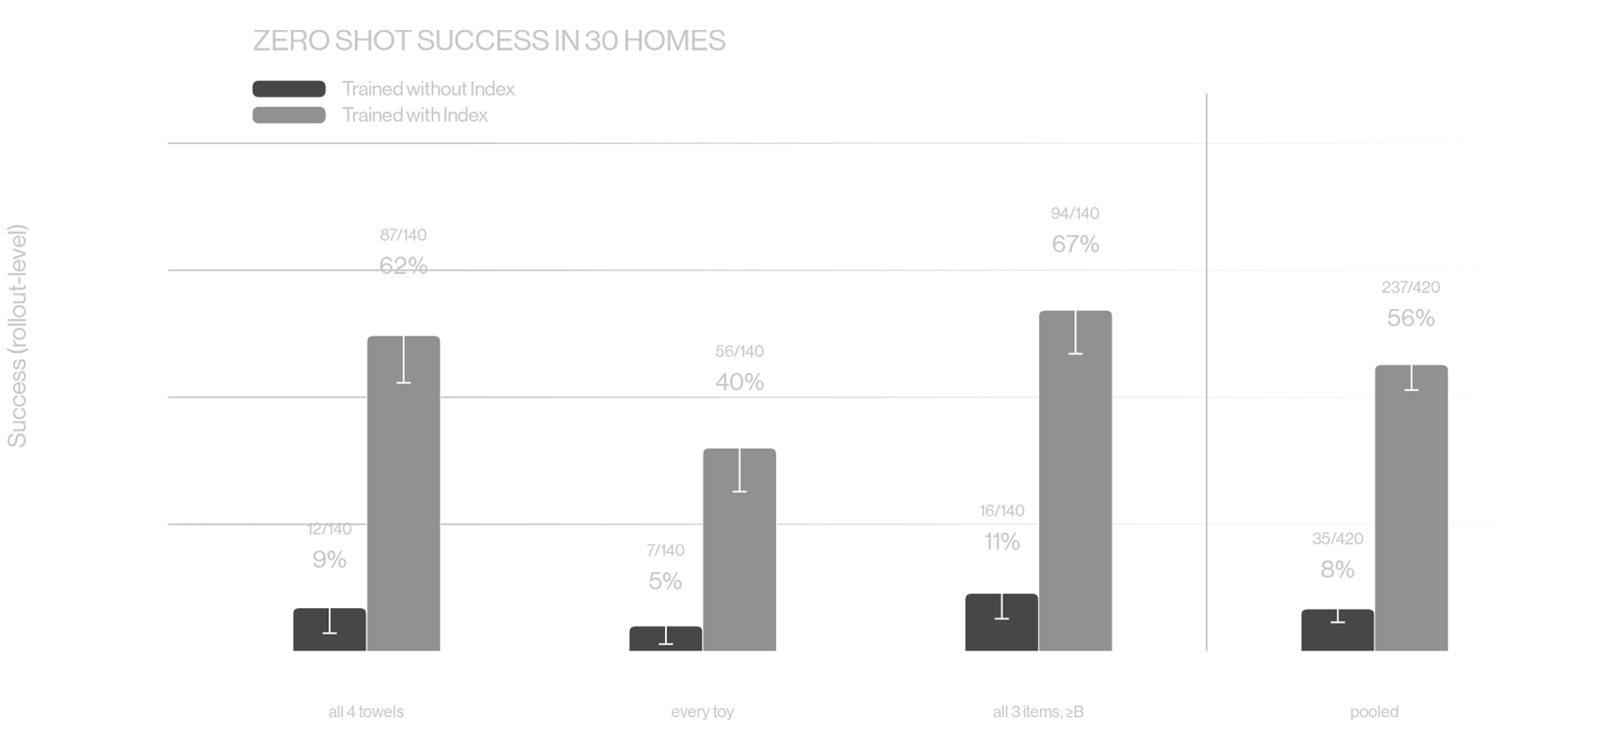 Kết quả chính thức của Figure. Cột đậm là huấn luyện không có Index, cột nhạt là có Index. Từ trái sang: gấp đủ 4 khăn (9% → 62%), dọn hết đồ chơi (5% → 40%), dọn đủ 3 món trên giường (11% → 67%), gộp tất cả (8% → 56%). Ảnh: Figure AI.
2. Skild S1: "nhắc bài" bằng video thay vì bằng lời
Skild S1 không nhận câu lệnh dạng chữ. Thay vào đó, bạn đưa cho mô hình một video người làm mẫu, đặt ngay trong cửa sổ ngữ cảnh (context window). Robot làm theo mà không cập nhật trọng số mô hình. Mô hình được huấn luyện trên 100.000 giờ dữ liệu.
Kết quả công bố là 66% trên các nhiệm vụ chưa từng gặp, so với 9% của một mô hình tương đương nhận lệnh bằng lời.
Cần đọc kỹ: theo phân tích của Turing Post, con số 66% đo tỉ lệ thành công cộng dồn theo từng bước, có con người can thiệp. Nó không phải tỉ lệ robot tự làm xong trọn vẹn nhiệm vụ. Vì vậy, đừng so trực tiếp con số này với 56% của Helix 2.5.
3. GEN-1.5 (Generalist): vài giây demo là đủ
Theo hướng tương tự Skild, GEN-1.5 dùng 3–12 giây video demo trong ngữ cảnh để thử các thao tác tinh như mở khóa kéo, vặn nắp lọ.
- Không huấn luyện thêm: tỉ lệ thành công trung bình 59% trên 10 nhiệm vụ.
- Sau 10 bước fine-tune, mỗi nhiệm vụ chỉ dùng 5 phút dữ liệu: tăng lên 83%.
Con số thứ hai rất thực tế: 5 phút dữ liệu cho mỗi việc mới là mức mà một nhà máy có thể tự thu thập được.
4. Facet-0: biết "cảm nhận lực" khi lắp ráp
Facet-0 kết hợp hình ảnh, câu lệnh và lực/mô-men đo ở cổ tay robot (cảm biến force-torque). Mô hình dự đoán cả chuyển động lẫn hiệu ứng tiếp xúc của chuyển động đó. Trên các tác vụ lắp ráp linh kiện máy tính cần độ chính xác cao, nó đạt 82%, so với 15% của baseline mạnh nhất. Lưu ý đây là kết quả trong điều kiện nghiên cứu có kiểm soát.
Thông điệp ở đây: với thao tác cần tiếp xúc như cắm, lắp, vặn, chỉ nhìn bằng camera là không đủ. Cảm biến lực vẫn là thành phần không thể thiếu.
Xu hướng chung
- Học từ demo trong ngữ cảnh (in-context learning). Robot học việc mới bằng cách "xem" video mẫu, giống cách LLM học từ ví dụ trong prompt, thay vì phải huấn luyện lại cả mô hình.
- Dữ liệu là lợi thế cạnh tranh. Bước nhảy 8% → 56% của Helix đến từ dữ liệu hành vi con người, không phải từ kiến trúc mô hình mới.
- Các con số chưa đo theo cùng một cách. Mỗi hãng đo "thành công" theo một kiểu (trọn vẹn hay từng bước, có hay không có người can thiệp). Khi đọc tin, luôn hỏi: đo cái gì, trong điều kiện nào?
Liên quan gì tới AMR?
Các mô hình trên chủ yếu nhắm vào thao tác bằng tay (manipulation). Với robot di động trong kho xưởng, phần điều hướng vẫn chủ yếu dựa trên SLAM, AMCL và Nav2 cổ điển, vì các phương pháp này dự đoán được và kiểm chứng được an toàn. Khả năng cao là trong vài năm tới hai thế giới sẽ kết hợp: Nav2 lo việc đi, mô hình VLA lo việc làm khi đã tới nơi. Muốn nắm vững nửa "đi", hãy bắt đầu từ khóa học ROS 2 & Nav2. Muốn tìm hiểu nửa "nhìn", xem chuyên mục Computer Vision & AI.
Nguồn: